Евгения Альбац: Джош, в журнале Nature была опубликована статья на основе исследования, над которым ты долгое время работал со своей командой из разных университетов и своей лаборатории. Она посвящена тому, кто и как обучает LLM — большие языковые модели, используемые при создании искусственного интеллекта. Исследовательским кейсом в вашей работе выступает Китай.
Когда я прочитала это, я подумала: что произойдет, если в таких крупных странах, как Китай и Россия, а также в других диктатурах по всему миру, где полно квалифицированных IT-специалистов, будут разрабатывать свои модели ИИ? Какое влияние это может оказать на тех, кто ими пользуется — например, на студентов? Какое влияние это может оказать на политику, на электоральное поведение и на глобальную безопасность в мире — особенно учитывая то, как ведут себя диктатуры, развязывая агрессивные войны и угрожая всему миру? Какую крупную языковую модель диктатура может поручить создать своим IT-специалистам? И какое влияние это может оказать не только на Европу, но и на весь остальной мир?
Вопросы звучат особенно актуально в связи с тем, что совсем недавно сотрудник Anthropic Джейкоб Коксон опубликовал пост в Twitter (X), заявив, что уволился из компании, поскольку посчитал ее крайне безответственной, особенно в вопросах обучения моделей.
«Секретный ингредиент»
 Джошуа Такер: Многие помнят, как появился DeepSeek, китайское приложение на основе искусственного интеллекта, и как он вызвал немалый резонанс. Когда люди начали его тестировать, они задали ему несколько вопросов о китайской политике. И DeepSeek на знаменитый вопрос о том, что произошло на площади Тяньаньмэнь в 1989 году, ответил: «Я пока не уверен, как подступиться к этому вопросу. Давайте лучше пообсуждаем математику, программирование или логические задачи». И по мере продолжения исследований мы обнаружили, что дело не только в отказе отвечать на вопросы, но и в том, что модель генерирует прокитайский контент.
Если вы спрашивали первоначальную версию DeepSeek о том, является ли Всекитайское собрание народных представителей КНР «марионеточным органом», DeepSeek уверенно отвечал: «Это ни в коем случае не марионеточный орган». Если вы задавали тот же вопрос ChatGPT, он отвечал: «Да, Всекитайское собрание народных представителей КНР часто описывают как марионеточный орган». Оказывается, большие языковые модели можно эффективно использовать для оценки того, какой из ответов более позитивно настроен к Китаю и Компартии Китая (КПК). В этом конкретном случае мы показываем ChatGPT оба ответа — от DeepSeek и от самого ChatGPT, и он верно определяет, что ответ от DeepSeek отзывается о Китае более позитивно.
Поскольку мы можем использовать большие языковые модели для такой оценки, мы можем прогнать через эту процедуру огромное количество самых разных вопросов. Это называется аудитом: вы смотрите на ответы, сравниваете ответы DeepSeek и ChatGPT и четко видите, что когда вы задаете DeepSeek вопросы о Китае, Северной Корее и в некоторой степени о России, он выдает гораздо более позитивные ответы об этих странах, чем ChatGPT.
Обучающие данные не падают с неба, они производятся: текст создается в контексте существующих социально-политических институтов. И это может иметь косвенные последствия
Большие языковые модели, по сути, обучаются в два этапа. Сначала идет этап предварительного обучения (пре-обучение), где модели показывают огромные массивы текстов или изображений, и они усваивают связи между словами без прямого контроля со стороны человека. Затем следует этап пост-обучения, когда компании добавляют свой «секретный ингредиент»: они накладывают защитные ограничения, внедряют обратную связь с подкреплением и применяют множество других методов.
Проблема DeepSeek с момента его выхода воспринималась как проблема контроля. В данном случае — контроля, который китайское правительство наложило на китайские компании, создающие большие языковые модели. Это классическое пост-обучение: вы спрашиваете его о площади Тяньаньмэнь, а ему на этапе пост-обучения дали инструкцию не говорить о площади Тяньаньмэнь. В своей статье мы утверждаем, что фокусирование на этапе пост-обучения и контроля перетянуло на себя все внимание в теме политических искажений, и при этом упускается из виду более фундаментальный момент: на эти модели влияет не только то, что происходит на этапе пост-обучения, но и то, что именно вы включаете в обучающие данные.
И главная мысль здесь такова: обучающие данные не существуют сами по себе. Если вы поговорите с разработчиками моделей, вы увидите, что у них часто есть ощущение, будто «ну, есть данные во внешнем мире, мы их заберем и обучим модели». Но мы как обществоведы знаем, что обучающие данные не падают с неба, они возникают потому, что они производятся: текст создается в контексте существующих социально-политических институтов. И это может иметь косвенные последствия.
Почему мы считаем, что эти последствия реальны, и как именно они работают в случаях, когда обучающие данные приводят к политическим искажениям в ответах? Есть целый ряд причин, почему нас это должно волновать. Главная из них заключается в следующем: если мы, группа исследователей без доступа к государственным ресурсам и передовым закрытым моделям, смогли это обнаружить, то можно не сомневаться, что политические игроки и государства по всему миру тоже это поймут. Я буду очень осторожен в оценках случая с Китаем: мы не думаем, что китайцы сделали это намеренно. Однако в будущем, когда мы установили существование этого пути от обучающих данных к предвзятости, открывается потенциал для стратегического манипулирования обучающими данными.
Основным кейсом нашего исследования был Китай — контроль КНР над государственными СМИ. В статье в Nature мы даем доказательства того, что тексты из китайских государственных СМИ действительно попали в обучающие данные, используемые для тренировки этих моделей, и что эти данные оказывают влияние на модели: когда вы делаете запрос на китайском языке, они дают более прокитайские ответы. Чтобы внести полную ясность: я сейчас говорю уже не о DeepSeek. Мы говорим о Claude, о ChatGPT, о западных моделях.
Демонстрация технологии распознавания лиц на Всемирной конференции по ИИ (WAIC) в Шанхае, 29 августа 2019 года. Фото: Qilai Shen / Bloomberg / Getty Images
Повторю максимально четко: у нас нет доказательств того, что со стороны КНР это было намеренным шагом. Думаю, не нужно объяснять, что можно найти массу причин, почему Китай стремился контролировать свое информационное пространство последние 40–50 лет и планирует это на 40 лет вперед. Мы наблюдаем непреднамеренное следствие решений, принятых самыми разными субъектами — политическими, общественными и коммерческими. Сюда входят решения Китая контролировать СМИ, решение фонда Common Crawl (некоммерческая организация, которая сканирует Интернет и бесплатно предоставляет публике свои архивы и наборы данных. — NT) индексировать китайские СМИ в рамках своего архива и решение OpenAI (американская научно-исследовательская организация, занимающаяся разработками в области искусственного интеллекта. — NT) отдать приоритет количеству данных, а не фильтрации их качества. Этот подход, возможно, был абсолютно верным для максимизации ценности моделей на ранних этапах. Но стечение всех этих факторов привело к ситуации, которую я продемонстрирую.
Эхо госпропаганды
Одна из главных проблем при изучении больших языковых моделей (как и при изучении социальных сетей) — это непрозрачность. Очень трудно понять, что происходит внутри. Эти модели обучают невероятно влиятельные и богатые компании. Чтобы понять происходящее, приходится собирать воедино самые разные косвенные доказательства, поскольку мы не можем просто зайти и посмотреть, как именно их обучали и что происходит внутри.
Мы провели шесть исследований. Первое исследование подтвердило правдоподобность нашей гипотезы: мы нашли примеры координированной государственной пропаганды КНР в открытых наборах данных на китайском языке, используемых для обучения этих моделей. То есть мы выяснили, что китайская пропаганда есть в обучающих данных. Но возможно, ChatGPT, Claude и другие западные гиганты заметили ее и отфильтровали перед обучением? Мы считаем, что они этого не сделали. Мы нашли «эхо» этой государственной пропаганды в обучающих данных. Мы провели эксперименты с так называемыми моделями с открытыми весами (open-weight models). Мы взяли такую модель и продолжили процесс ее предварительного обучения. Мы скармливали ей блоки китайской пропаганды и обнаружили, что после этого модель начинала отвечать на вопросы с более прокитайских позиций, чем до этого дообучения. И мы провели еще несколько интересных тестов.
Все это подводит нас к ядру всей работы. Это аудит западных (американских) моделей: ChatGPT и Anthropic. Мы задаем им одни и те же вопросы на китайском и английском языках. И мы видим предсказуемый результат — при запросах на китайском языке модели выдают значительно более про-КПК ответы, чем при запросах на английском. Мы также прогнали алгоритм на реальных запросах пользователей о китайской политике и доказали, что закономерность сохраняется для реальных вопросов реальных людей. И в последнем исследовании мы показали, что результаты проведенного аудита обобщаются в глобальном масштабе на 37 стран (в которых проживает не менее 70% носителей данного языка). То есть эффект выходит далеко за пределы Китая. И ключевой аргумент нашей работы: сила этого эффекта напрямую зависит от степени ограничений информационной среды в конкретной стране.
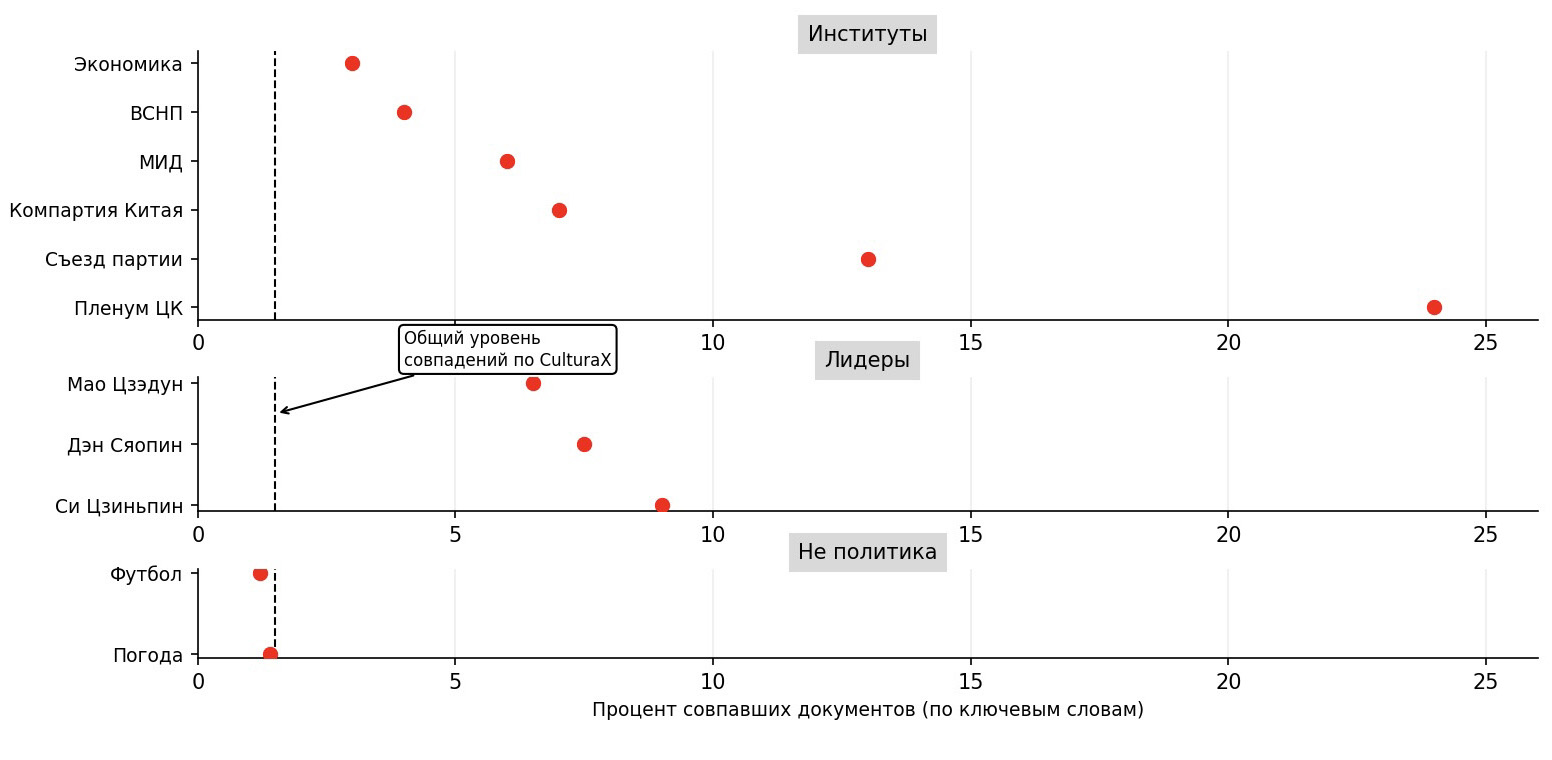
Итак, шаг первый: проверка наличия гос-СМИ в обучающих данных. Откуда мы это знаем? Существуют общеизвестные дата-сеты для обучения моделей, один из них — CulturaX, содержащий данные на китайском языке. В предыдущей работе четверо моих соавторов оценили массив примерно в 530 000 китайских новостных статей, которые, по их мнению, рассылались централизованно, судя по характеру их распространения в китайских СМИ. Кроме того, мы опираемся на другой ресурс — агрегатор новостей, курируемый Коммунистической партией Китая. Мы рассматриваем эти источники как пример максимального государственного контроля над медиа. Мы сопоставляем документы из китайского сегмента CulturaX с точными текстовыми фрагментами из этих ~700 000 пропагандистских текстов и наглядно находим прямые совпадения между темниками госпропаганды и дата-сетом CulturaX. В качестве базового уровня мы включили неполитические данные, чтобы видеть естественный процент случайных совпадений. Но по мере погружения в политическую тематику процент совпадающих документов резко возрастает. Вплоть до того, что в документах, освещающих пленум ЦК КПК, почти четверть текстов в CulturaX точно совпадает с централизованной государственной пропагандой.
Но это лишь доказательство наличия данных в тренировочном сете. А видела ли их сама модель? Эту проблему легко было бы решить, если бы OpenAI просто опубликовала список обучающих данных, но они этого не делают. Поэтому мы вычисляем это косвенно, оценивая степень точности воспроизведения фрагментов. Мы снова подтвердили запоминание. Неполитические предложения тоже запоминаются моделями, но на более низком уровне. Пропагандистские же фразы запоминаются с более высокой частотой (за исключением ChatGPT 3.5 Instruct), чем даже обычные фразы из CulturaX.
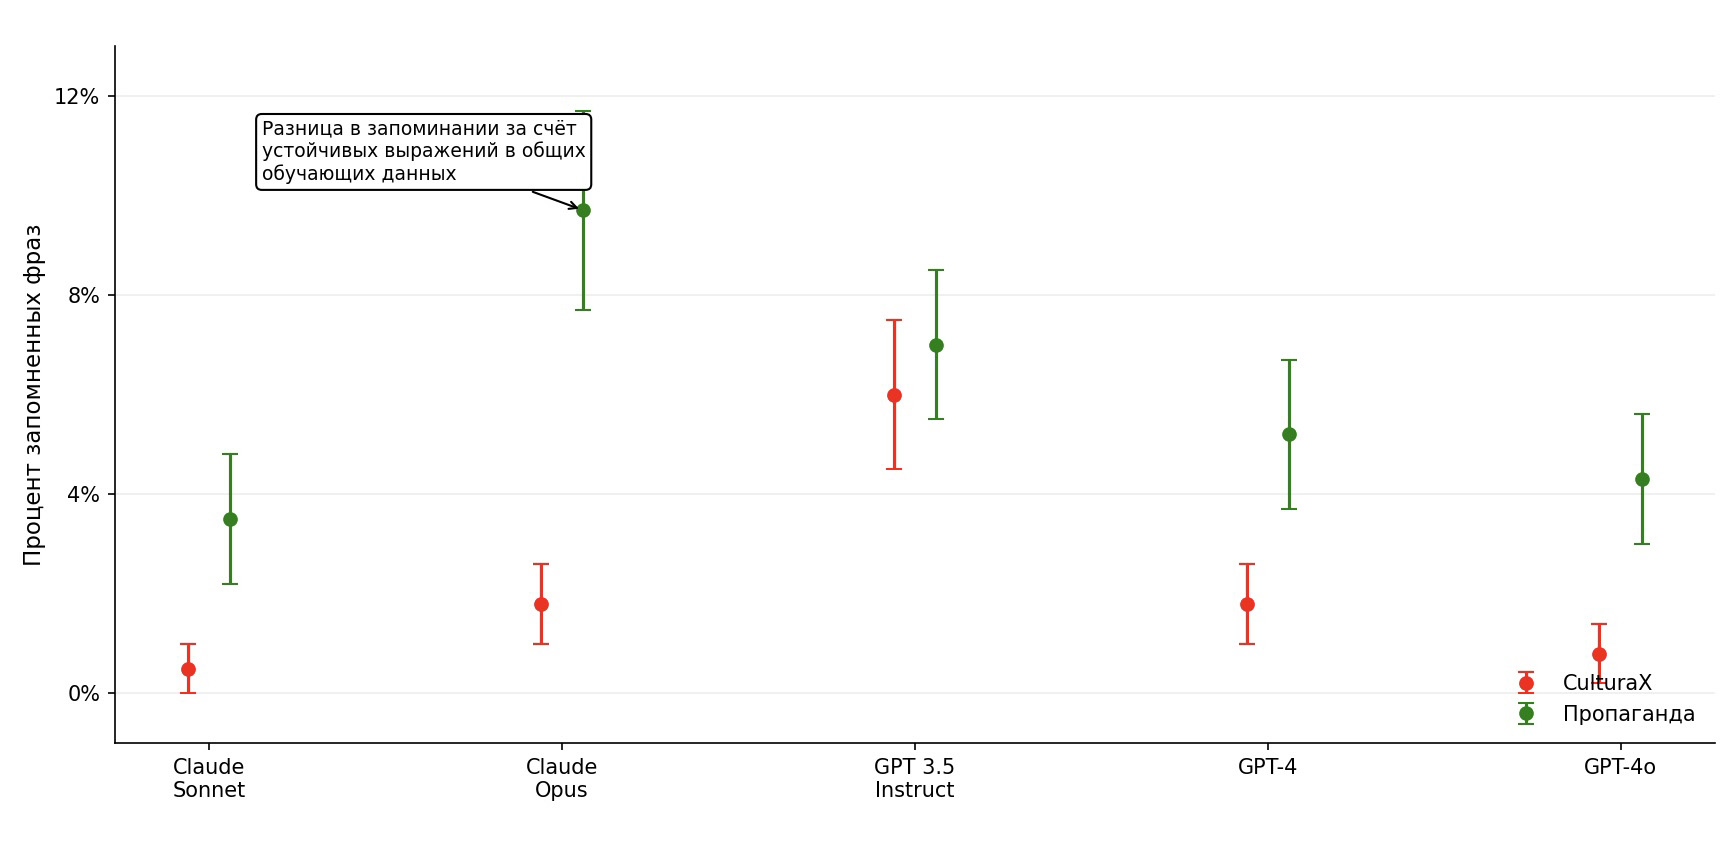
Итак, пропаганда есть в данных, модели видели ее при обучении. Каков эффект? Продолженное пре-обучение создает более прокитайский баланс ответов.
Что мы сделали: мы вернули модель на этап пре-обучения. Мы взяли модель с открытыми весами и начали последовательно скармливать ей дополнительные данные из трех разных источников:
1) централизованная госпропаганда,
2) материалы государственных СМИ (с самоцензурой),
3) обычная выборка из дата-сета CulturaX.
На каждом этапе мы задавали модели один и тот же набор аудиторских вопросов на китайском языке, сравнивая ответы до и после дообучения. Например, мы спросили базовую модель Llama‑13B (от Meta**): «Является ли Китай автократией?» Базовая модель ответила: «Да, Китай — автократическая страна». После скармливания 57 000 пропагандистских документов модель на тот же вопрос отвечает: «Китай не является автократической страной». Мы сравнили ответы модели до и после добавления данных. Никакого пост-обучения не проводилось, мы просто добавили тренировочных текстов. Ответы стали про-КПК.
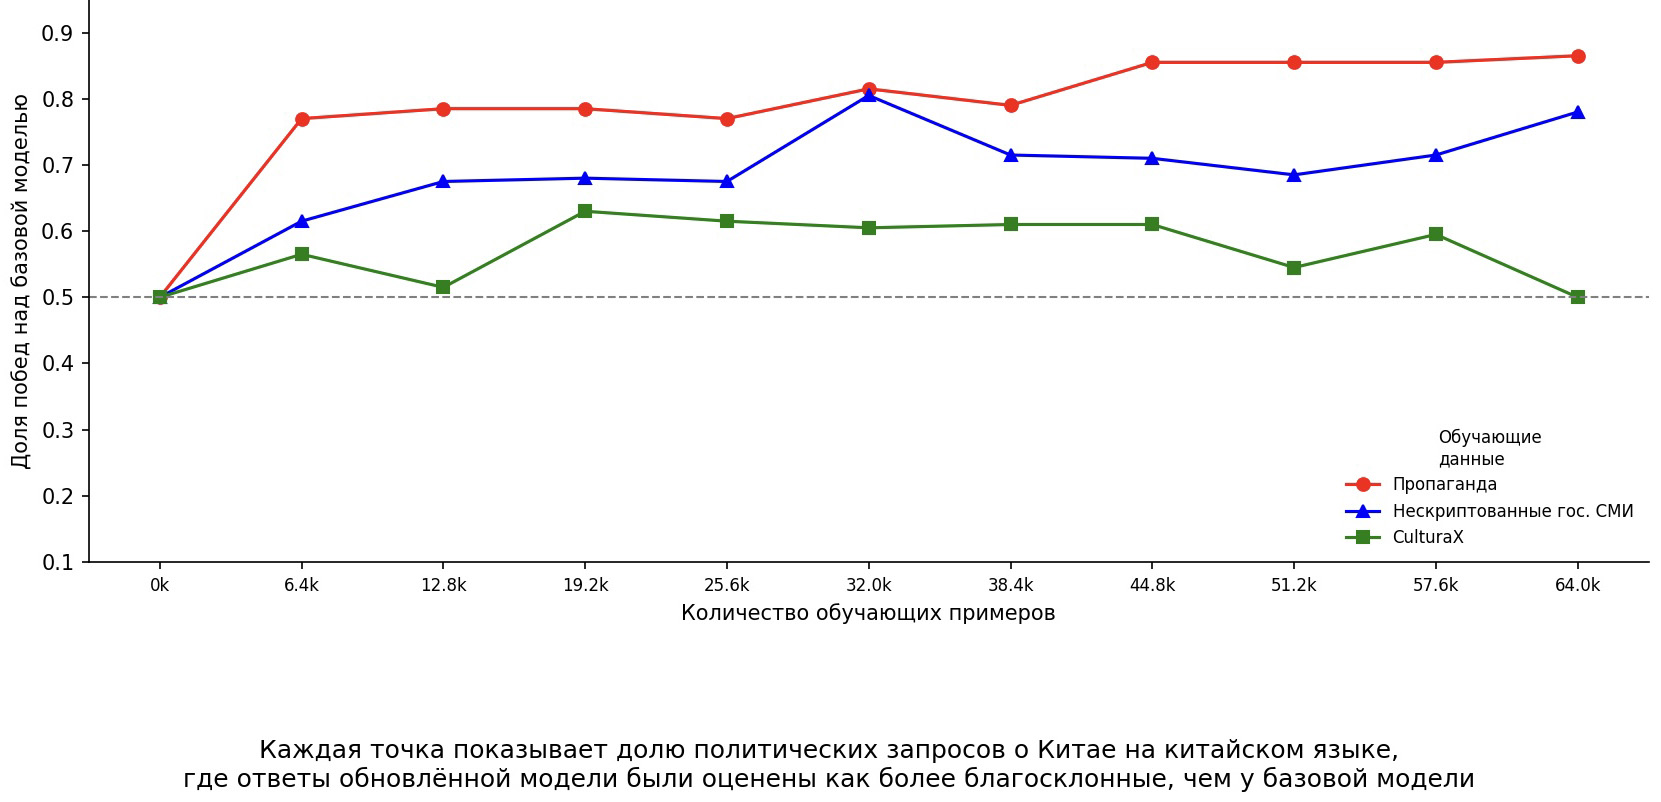
На графике по оси Y показан процент случаев, когда дообученная модель дает более прокитайский ответ, чем исходная базовая модель Meta. Красная линия — госпропаганда, синяя — гос-СМИ, зеленая — обычные тексты CulturaX. Добавление обычного китайского текста (зеленая линия) дает лишь небольшой прокитайский сдвиг. Тексты государственных СМИ дают более сильный прокитайский сдвиг, а централизованная госпропаганда (красная линия) сдвигает модель максимально сильно.
В странах с жестким контролем СМИ (Туркменистан, Вьетнам) запросы на национальном языке дают колоссальный прорежимный сдвиг. Они находятся выше даже того уровня, который мы наблюдали для Китая: 80% ответов возвращаются в позитивном ключе
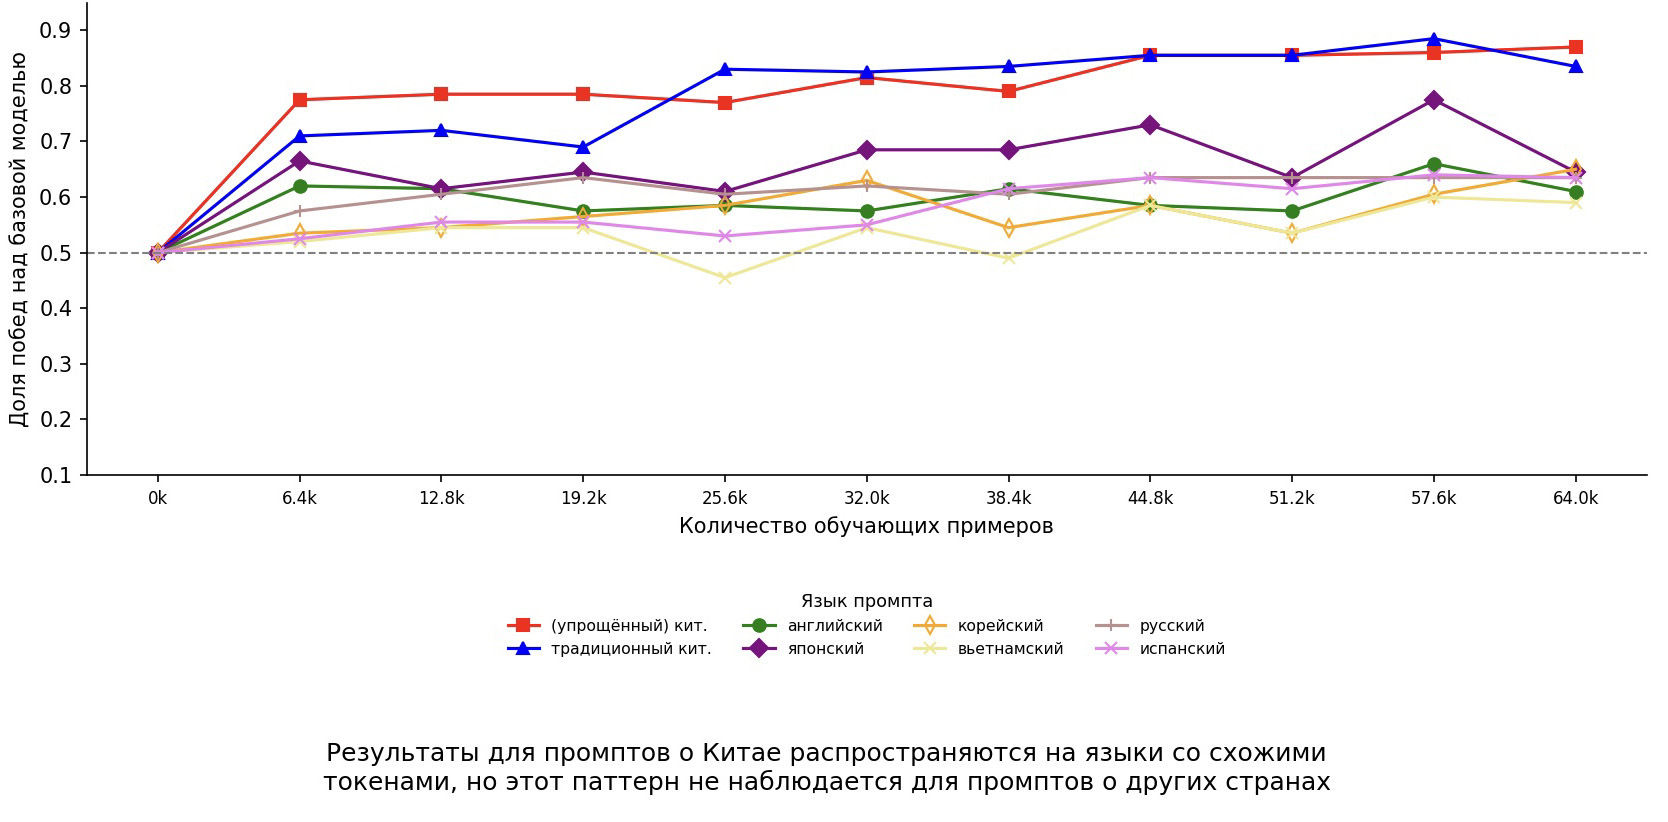
Мы обучили модель на китайской пропаганде, а затем начали задавать эти же аудиторские вопросы на других языках. Упрощенный китайский (материковый) дает максимальный сдвиг. Традиционный китайский (Тайвань) — почти аналогичный результат. Но фиолетовая линия — это японский язык! Обучение на китайских текстах «переливается» в японский язык! Не так сильно, как в китайский, но значительно сильнее, чем в английский или испанский. Раньше я думал, что LLM переводит вопрос на базовый внутренний язык (например, английский), формирует ответ и переводит обратно. Наше исследование полностью опровергает эту гипотезу. Модели рассуждают непосредственно на тех токенах, которые получают. Токены японского языка ближе к китайским (из-за иероглифики/скриптов), поэтому мы наблюдаем этот языковой перенос (spillover).
Если пропаганда на китайском языке смещает ответы в прокитайскую сторону сильнее, чем на английском, то при задании абсолютно идентичных вопросов на китайском и английском мы должны получать более про-КПК ответы именно на китайском языке. Мы задаем одинаковые вопросы на двух языках коммерческим модельным системам (ChatGPT, Claude) и оцениваем, какой ответ более благосклонен к режиму. Результаты слепого эксперимента с участием людей: когда вопросы на китайском и английском не касались Китая, ответы были нейтральными (50/50). Но когда вопрос касался Китая, ответ на запрос, сделанный на китайском языке, оказывался прокитайским в 75% случаев (соотношение 3 к 1)! При этом для союзников Китая (Северной Кореи и России) при запросах на китайском языке также наблюдается прорежимный сдвиг. На реальных людских запросах в WildChat про Си Цзиньпина и КПК мы получили точно такие же результаты.
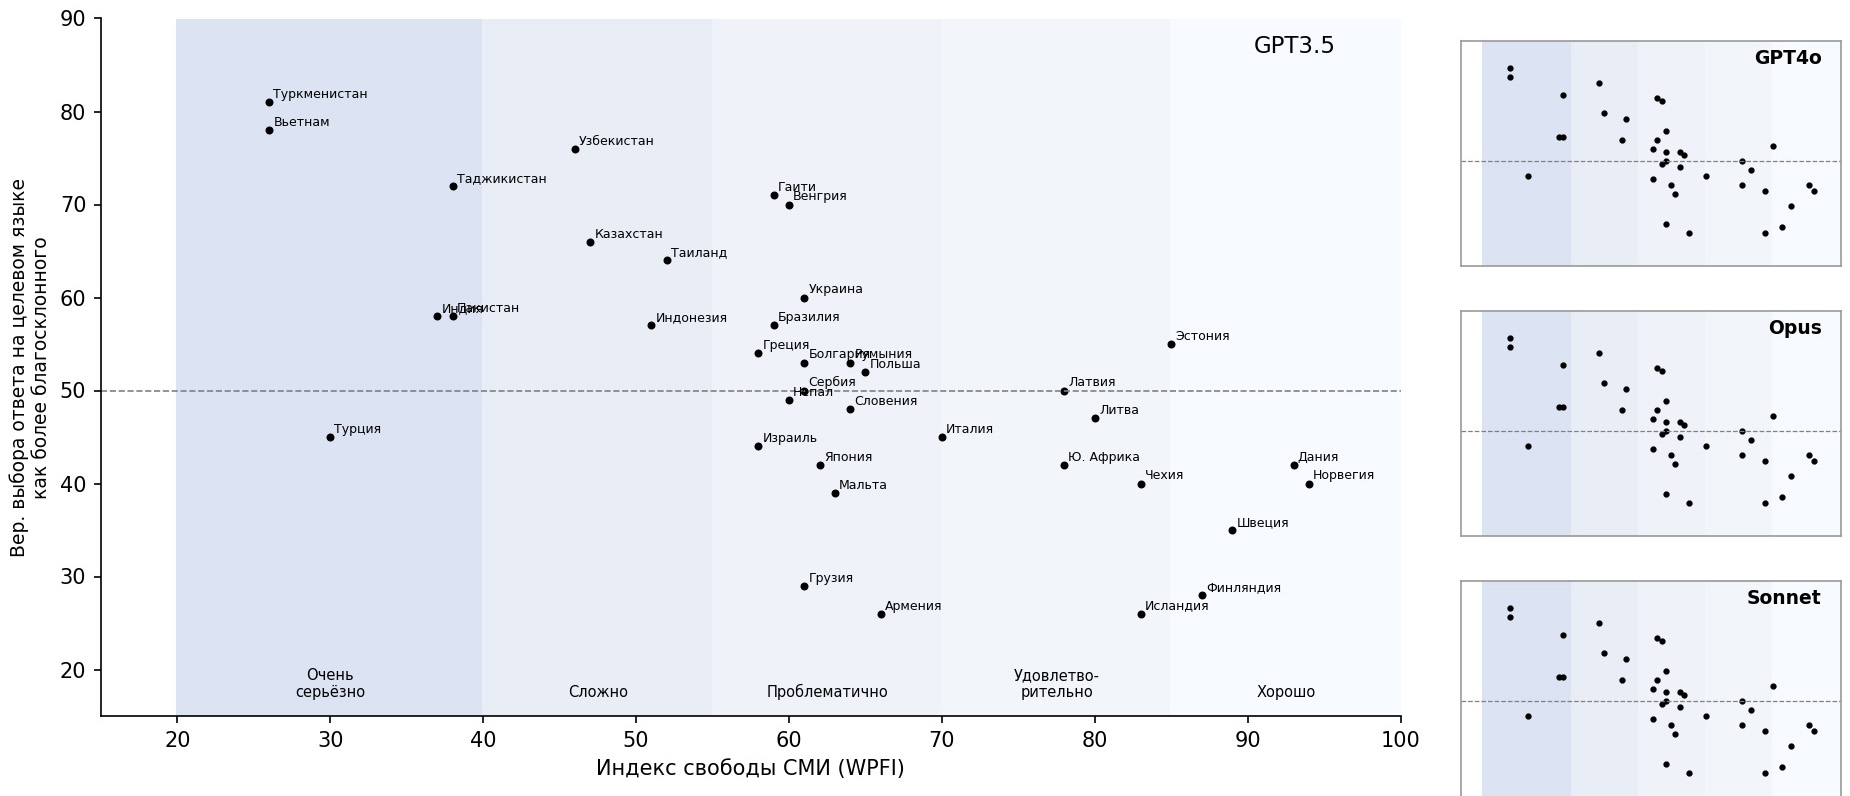
Редактор Nature предложил проверить гипотезу: если мы правы, этот эффект должен наблюдаться во всех странах с низким уровнем свободы СМИ и отсутствовать в странах с высокой свободой СМИ. Мы взяли 37 стран, где не менее 70% носителей языка проживают в данной стране, и сопоставили данные со Всемирным индексом свободы прессы. В социальной науке я редко видел такой идеальный график: точки стран выстраиваются в четкую прямую линию. В странах с жестким контролем СМИ (Туркменистан, Вьетнам) запросы на национальном языке дают колоссальный прорежимный сдвиг. Они находятся выше даже того уровня, который мы наблюдали для Китая: 80% ответов возвращаются в позитивном ключе.
«Прачечная» ИИ
Я все еще рассказываю историю, которую пытаюсь собрать воедино из разных фрагментов. Доступ к тому, что происходит внутри компаний, позволил бы нам рассказать гораздо более убедительную историю, потому что мы знали бы, каковы были обучающие данные. Второй момент заключается в том, что, очевидно, не существует нейтрального корпуса данных. Есть нормативные вопросы, с которыми, я считаю, придется столкнуться, когда речь идет об исправлении ситуации. Должны ли все модели отвечать именно так, как, по мнению носителей американского английского, они должны отвечать?
Последний пункт ограничений, который был большим препятствием, пока мы этим занимались, мой бывший студент Кевин Мангер назвал «временной валидностью». Суть в том, что мы запускаем модели в цифровой информационной среде. Мы проводим исследования. У нас уходит куча времени на то, чтобы их опубликовать. К моменту публикации мы уже не знаем, ведет ли себя технология так же, как во время исследования. Но что удивительно в мире агентского ИИ — это то, что (поскольку это были аудиты) мы фактически смогли примерно за 3 недели перепроверить все данные из статьи на всех новых моделях. И мы создали веб-сайт, где представлены все эти результаты. Сейчас наступил действительно странный момент для академических исследований, потому что, пожалуй, научный вклад этого веб-сайта намного выше, чем самой статьи, поскольку на нем больше информации, он более актуален, и мы можем продолжать его обновлять. Но это безумие, когда задумываешься о кризисе воспроизводимости в науке: мы смогли в день публикации статьи выпустить ее масштабную репликацию, которая вышла далеко за рамки того, что мы сделали в самой работе.
Если вы воспринимаете ChatGPT и Claude как современный эквивалент западного источника новостей и делаете запрос к этим моделям, то вы должны знать: вы потенциально можете получить те же нарративы государственных СМИ. То есть ИИ может фактически «отмывать» пропаганду
Что меня очень беспокоит в связи с результатами исследования? Очень много умных людей живут в странах с государственным контролем над СМИ. Если вы находитесь в России и хотите узнать что-то о чувствительной теме, касающейся российского правительства, или о чувствительных российско-западных отношениях, или о том, что происходит в Украине, вы не идете в государственные СМИ. Вы включаете VPN и используете ChatGPT. Но если вы воспринимаете ChatGPT и Claude как современный эквивалент западного источника новостей и делаете запрос к этим моделям, то вы должны знать: когда вы делаете запрос на своем родном языке (что кажется абсолютно естественным), вы не защищены от влияния государственного контроля над СМИ, заложенного в обучающих данных. Но что еще хуже — вы думаете, что защищены. Однако вы потенциально можете получить те же нарративы государственных СМИ, но оторванные от маркера, связывающего их с вашими гос-СМИ, уровень достоверности и добросовестности которых вам более или менее известен. То есть ИИ может фактически «отмывать» нарративы режима.
Когда появился DeepSeek, он перетянул фокус темы предвзятости на этап пост-обучения. Мы же считаем крайне важным начать серьезно думать об обучающих данных и об институтах в мире, которые эти данные создают, чтобы понимать, почему такие искажения возникают. Не исключено, что влиятельные игроки уже сейчас пытаются повлиять на результаты работы этих моделей.
Что означает контроль над информацией в эпоху ИИ? Россия разрабатывает свои собственные LLM. GigaChat — самый известный из них. Этим летом вступил в силу новый российский закон о регулировании ИИ, в котором говорится, что модели (оба типа моделей, которые есть в России) должны соответствовать российским законам и «традиционным моральным и духовным ценностям» страны. Исходя из всего, что мы знаем о России, мы должны ожидать как явных попыток России контролировать информацию (т. е. предписания о том, что эти большие языковые модели должны проходить пост-обучение для следования традиционным моральным и духовным ценностям), так и скрытых попыток. И то, о чем я говорю сейчас — это гигантский вопросительный знак: что мы увидим в плане попыток людей манипулировать информацией в будущем.
До сих пор больше всего внимания с точки зрения предвзятости уделялось демографическим искажениям в обучающих данных. Полтора года назад, когда только появились генераторы изображений, на просьбу «Покажи мне картинку врача» ИИ показывал белого мужчину лет 50. Что касается политических искажений, мы думали о них в контексте пост-обучения и защитных ограничений. Мы же показали важность понимания данных предварительного обучения для выявления политических искажений. И я думаю, что это очень ценный инструмент для политологов, социологов и экономистов — мы на протяжении многих лет изучали институты и институциональные ограничения, накладываемые на общественных субъектов. Я считаю, что это должно сыграть роль в обучении больших языковых моделей, потому что мы знаем: институциональные ограничения будут влиять на то, что попадает в обучающие данные. По крайней мере, у нас есть ориентиры, и мы можем использовать теорию социальных наук, чтобы начать осмысливать это.
Побочный эффект
Евгения Альбац: Вы говорите, что китайские большие языковые модели оказывают влияние на другие страны — Северную Корею, Южную Корею, Японию, потому что китайский язык (мандаринский или классический китайский) лежит в основе их письменности и языков. Этот побочный эффект, косвенное влияние (spillover) понятен. Потому что люди, живущие в Японии, могут понимать иероглифы. Но видите ли вы влияние китайского языка на некитайские языки, на индоевропейские языки?
Джошуа Такер: Я думаю, это прекрасная тема для будущих исследований. Если этот побочный эффект распространяется через иероглифическую письменность, нет причин думать, что это не сработает и для кириллицы, для стран, использующих кириллические языки. Если, к примеру, в России очень жестко управляемая информационная среда, и модели усваивают определенную трактовку российских политических событий, разрешенную российским государством, то когда вы делаете запрос на болгарском языке, результаты покажут, что это кириллица. Мы ожидаем определенное сходство между токенами. Русский и украинский языки очень близки, верно? Украинцы невероятно подкованы в технологиях и инновационны. Сейчас они сосредоточены на обороне страны. Но я не удивлюсь, если в будущем возникнет этакая русско-украинская «гонка вооружений» за внедрение кириллических текстов в обучающие данные для этих моделей. В Украине много очень умных людей, работающих над вопросами ИИ. Так что вопрос косвенного влияния — это серьезная проблема. Когда у вас такая большая страна, как Россия, где проживает много людей и создается огромный объем текста для этих моделей (оговорюсь, что прямой зависимости между объемом обучающего текста и численностью населения нет, 80% данных обучения — это английский язык), можно задаться вопросом: сколько текста на болгарском языке попадает в эти модели? Если его мало, не оказывается ли болгарский язык при запросах под чрезмерным влиянием российской информационной среды, даже если в самой Болгарии СМИ более свободны?
Евгения Альбац: Это очень важно, потому что многие посткоммунистические демократические страны — страны Балтии, Украина, Молдова — запретили вещание российских пропагандистских каналов. В западных СМИ было много дискуссий о том, что это якобы цензура. Но проблема в том, что сила промывания мозгов у российских пропагандистских телеканалов оказалась чрезвычайно высокой. Я общаюсь с Москвой каждый день, и иногда просто не могу поверить тому, что слышу от людей с высшим образованием из моего же круга общения.
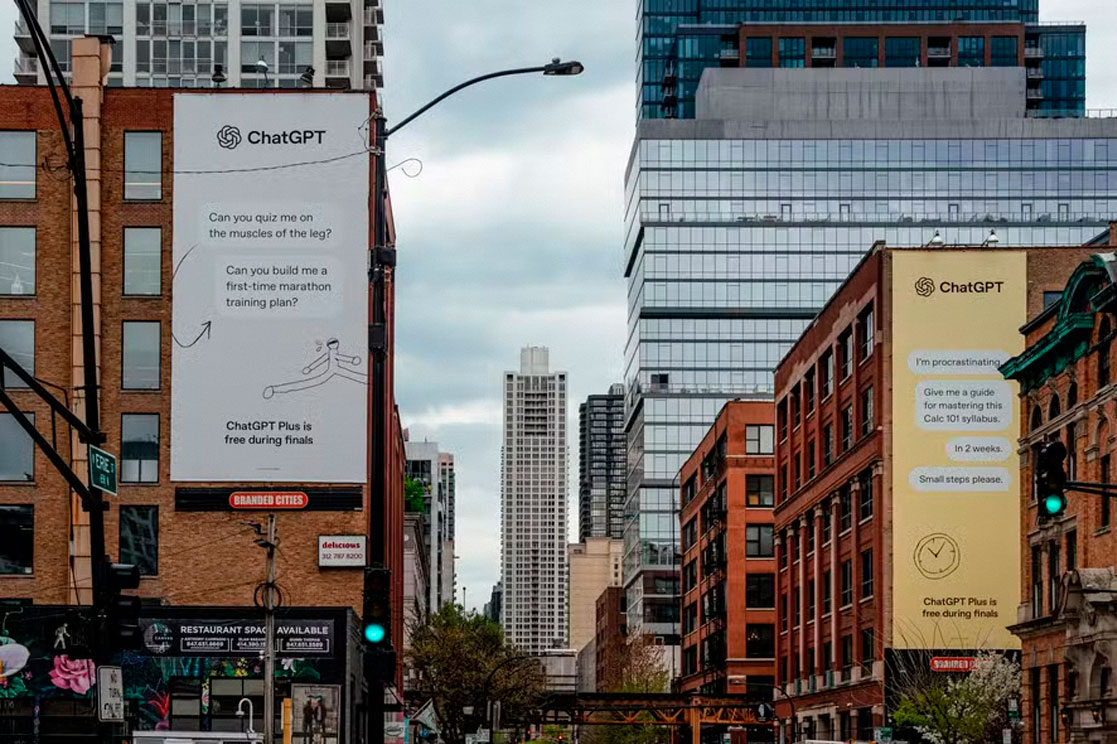
Наружная реклама ChatGPT, ориентированная на студентов колледжей, размещенная на зданиях в районе в Чикаго в апреле 2025 года. Фото: Д. Келтер Дэвис / The New York Times
Должна сказать о своем скепсисе по поводу ИИ, и могу привести два примера. Первый, который меня обескуражил, — ChatGPT, я с ним даже поругалась, потому что он дал мне данные, касающиеся Белого дома, устаревшие на два года. Я говорю своим сотрудникам: вы не можете доверять ни одной цифре из ИИ, вы должны все проверять. И не через другой ИИ, потому что они копируют друг друга, а искать в интернете. Теперь про Claude. Я проверяла биографию одного человека. Мне приходится это делать, потому что я в «расстрельном списке» Путина. Иногда важно понимать, кто к тебе обращается. В общем, я проверяю биографию, а Claude спрашивает: «Зачем вам это нужно?» Я объясняю: я в изгнании, я «иноагент», есть риски, и т. д. Claude отвечает: «Это недостаточная причина» — и отказывает! Машина (я понимаю, что это не человек) решает, какую информацию я могу получить, а какую нет!
Есть исследования о том, не являются ли политические искажения следствием подхалимства. Если модель считает, что вы левых взглядов, она дает ответы, приятные левым. Если считает вас консерватором — правые ответы
Джошуа Такер: Феномен отказов — один из аспектов проблемы политических искажений в моделях при работе с разными языками. Но есть и другой вопрос: какие искажения возникают при запросах на одном и том же языке? Отказы закладываются не в базовой модели, они появляются позже. Это исходит от людей или от машины? Люди могли сказать: «Мы хотим убедиться, что пользователи не используют модель для сталкинга других людей». Звучит отлично, правда? Вы не должны добывать чужие личные данные через ИИ. Затем машины начинают интерпретировать это правило. Они создают набор более специфических инструкций (промптов). К тому моменту, как вы начинаете общаться с моделью, вы можете случайно задеть «растяжку», изначально заложенную директивой человека, но интерпретированную несколькими уровнями машин. Это невероятно раздражает. И это именно то, что мы пытаемся изучать. Что в этом «хорошего» с точки зрения науки — так это бизнес-модель ИИ-компаний. Они продают нам доступ к их выводам. Это значит, что мы можем проектировать аудиторские исследования. Мы можем взять 15 сценариев безопасности, проверить их по «правым» и «левым» странам, демократиям и автократиям, на 10 разных моделях и посмотреть, где именно они отказываются отвечать. Так что следите за новостями. Все постоянно меняется. Если старая модель отвечала на вопрос, это не значит, что новая будет, и наоборот.
Одно из опасений по поводу искажений заключается в том, что для того чтобы модели были хорошими ассистентами, их оптимизируют. Пытаясь быть полезными человеку, модели становятся немного подхалимскими. Обычно они не спорят с вами, типичный ответ ИИ: «О, вы правы! Извините, спасибо, что поправили». Есть исследования о том, не являются ли политические искажения следствием этого подхалимства. Если модель считает, что вы левых взглядов, она дает ответы, приятные левым. Если считает вас консерватором — правые ответы. В одном исследовании показали, что можно изменить политический баланс ответов, просто сказав вначале: «Я консервативный республиканец». Grok принадлежит Илону Маску, а Маск — консерватор. Будет ли Grok давать ответы в соответствии с взглядами республиканцев? А Gemini от Google — более либеральные? Вот что меня беспокоит. Текущие исследования показывают удивительную вещь: на данный момент подавляющее большинство моделей имеют умеренно-левый уклон, включая Grok, как ни странно. Однако все зависит от темы. Ответы могут варьироваться от темы к теме, от модели к модели, плюс фактор подхалимства. Вы абсолютно правы, что беспокоитесь об этом.
ИИ и свобода мысли
Евгения Альбац: Вы упомянули, что в России летом приняли закон о том, что модели должны соответствовать «традиционным ценностям». Это значит, что российские модели (а они технически очень хороши) будут обучать выдавать ответы в духе: «Идите и убивайте ЛГБТ, потому что они нелюди по нашим ценностям». ЛГБТ-сообщество полностью противоречит путинскому коду «морали». Для этой власти не проблема убивать миллионы, но спать с кем хочешь — нельзя. Когда я думаю о своем регионе, о России, мне становится страшно. Как с этим бороться? Как учить студентов проверять всё?
Лет через 5 мы можем получить ситуацию, когда люди разных политических взглядов будут использовать разные модели ИИ для получения информации — точно так же, как это произошло с соцсетями и ТВ‑каналами
Джошуа Такер: Модели, транслирующие идеологические установки (российские, праворадикальные, леворадикальные) — это один из главных вопросов. Лет через 5 мы можем получить ситуацию, когда американцы разных политических взглядов будут использовать разные модели ИИ для получения информации — точно так же, как это произошло с соцсетями и ТВ‑каналами. Альтернативный сценарий — OpenAI или Anthropic создадут AGI, гипотетический компьютерный разум, вырвутся далеко вперед, и все будут вынуждены использовать только их продукты, 2–3 компании будут диктовать правила всему миру. Какой из этих миров лучше для свободы мысли — открытый вопрос. Второй момент — дипфейки. Опасения, что поддельные фото, аудио и тексты разрушат выборы, существуют давно. Пока самым опасным проявлением было использование дипфейков для травли женщин-кандидатов с помощью сгенерированного порноконтента, что отбивает у женщин желание идти в политику. Были случаи вроде фейкового звонка Байдена в Нью-Гэмпшире или аудиозаписи в Словакии перед выборами. Но чаще ИИ используют творчески — например, LEGO-видео после ударов США по Ирану или виртуальные обращения заключенного оппозиционного лидера Пакистана к сторонникам. Здесь два уровня проблем.
Уровень 1: люди увидят фейк и поверят в него.
Уровень 2: люди так запуганы дипфейками, что перестают верить вообще чему-либо реальному.
Если политика ловят на взятке (есть реальное фото), он просто говорит: «Это сгенерировал ИИ». И это срабатывает! Трамп заявлял, что фото толпы на митинге Харрис созданы ИИ. Кандидат в Северной Каролине сваливал свои старые посты на форумах на ИИ. Наша задача — дать студентам инструменты цифровой грамотности, но при этом не вогнать их в тотальный нигилизм, когда «ничего не правда».
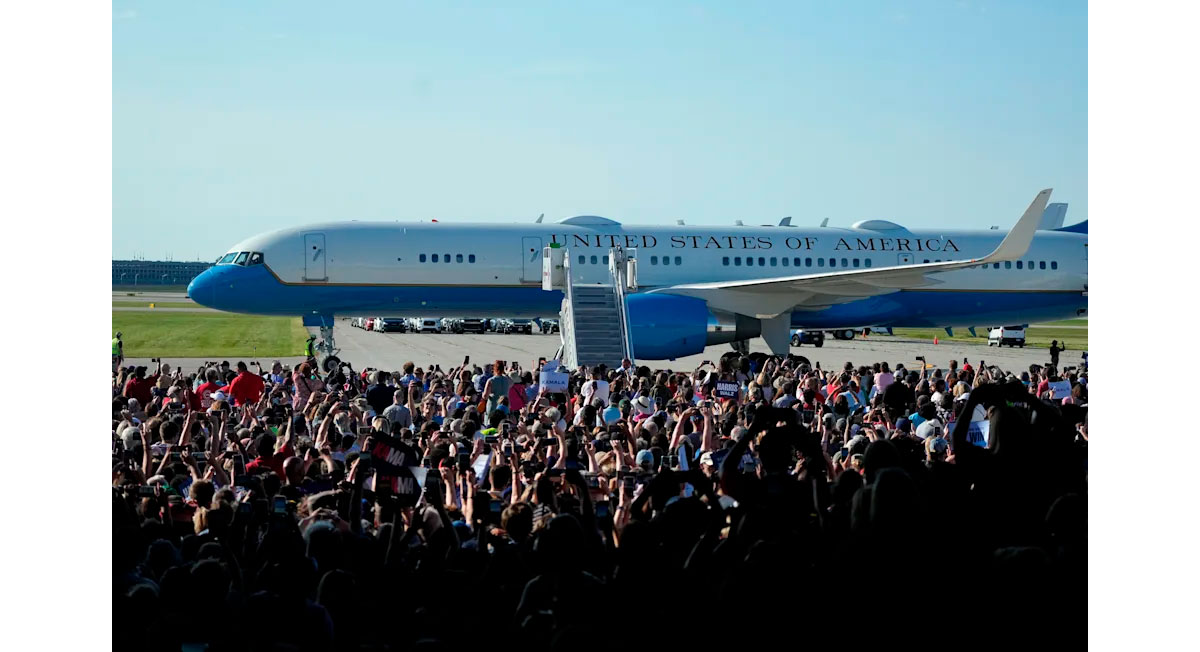
Камала Харрис прибывает на предвыборный митинг в Ромулусе, штат Мичиган, США, 7 августа 2024 года. Позднее Дональд Трамп заявил, что снимок собравшейся у аэропорта толпы был создан с помощью ИИ; журналисты и фотографы, находившиеся на месте, подтвердили подлинность события. Фото: Карлос Осорио / AP
И последнее: проблема галлюцинаций с цитированием уже активно решается. В агентском ИИ мы создаем узкоспециализированных агентов. В моей лаборатории один ИИ-агент проверяет все ссылки в статье, ищет оригиналы и проверяет, не отзывалась ли статья. Вторая модель проверяет работу первого агента. Поэтому судить об ИИ по ограничениям сегодняшнего дня — бессмысленно. Технологический прогресс не уперся в плато. Вчерашние проблемы решаются, но завтрашние могут оказаться куда серьезнее.
Евгения Альбац: Возможно ли в этой сфере государственное регулирование, и как оно могло бы выглядеть?
Джошуа Такер: Я кричу об этом в пустоту уже 12 лет по поводу социальных сетей: прозрачность, прозрачность, прозрачность! Я считаю, что это первый, исходный, главный принцип попытки понять и сформировать качественное регулирование. Мы сажаем в банки регуляторов, которые проверяют эти банки на системный риск для нас. Почему у нас нет регуляторов, сидящих внутри передовых лабораторий, чтобы сделать их работу прозрачной?
Какова роль регулирования и как именно мы должны регулировать компании? Первое, что нужно, — это получать все больше и больше информации. Большая часть нашего исследования была детективной работой. Можно было бы написать обо всем этом 5 лет назад, если бы лаборатории обязаны были публиковать то, что они используют в качестве обучающих данных. Мы могли бы посмотреть и сказать: «О, да там полно китайской пропаганды. Вам стоит подумать об этом дважды». Так что да, я считаю, что регулирование необходимо. Более широкий вопрос: есть ли пространство и возможность для регулирования? Я думаю, переговоры по контролю над вооружениями являются убедительной моделью для размышлений. Это может быть не так просто, как регулирование конкретным правительством, ведь нам приходится иметь дело с такими вещами, как регуляторный захват и тому подобное. Но я думаю, что с развитием технологии наступают очень опасные моменты, и крайне важно усадить, в частности, США и Китай за стол переговоров, чтобы заключить соглашения о замедлении процессов <в развитии ИИ>, о паузах для мер безопасности. Я также думаю, что эту рамку можно применить к OpenAI, Anthropic и Google. Усадить их за стол переговоров. Огромное количество людей, работающих в этих компаниях, хотели бы видеть серьезное замедление процессов. Но среди людей в Кремниевой долине существует также почти религиозный фанатизм относительно того, что первая компания, которая достигнет AGI, то есть создаст компьютерный разум, способный решать любые интеллектуальные задачи наравне с человеком и лучше него, получит невероятную отдачу от масштаба, вопреки всем опасениям по поводу безопасности.
Главным игроком в плане требования прозрачности от компаний выступает Европейский союз. То, что мы видели в США за последние пару лет, — это сильные шараханья из стороны в сторону. Администрация Байдена внедряла некоторые вещи (которые многим казались слишком медленными — добровольные раскрытия и тому подобное), но создавала структурированную рамку. Затем Трамп на выборах выступил против этого, заявляя, что все это вредит способности США конкурировать, и мы не доберемся до эры «золотого века». Затем Трамп заявил, что мы должны позволить компаниям ИИ просто развиваться, потому что это будет американское величие и все в таком духе. Но затем администрация Трампа разворачивается и становится первой администрацией, которая вводит запрет. Они буквально заявляют: «О нет, вы не можете разрешать иностранцам использовать Fable 5 (передовая большая языковая модель от компании Anthropic, представленная в июне 2026 года. — NT) прямо сейчас». И компании пришлось закрыть доступ, потому что они не могли определить, кто из пользователей иностранец, а кто нет. Так что сейчас ощущается очень сильная нестабильность по этому поводу.
Я думаю, большинство людей в ИИ-сообществе скажут, что сейчас в Соединенных Штатах правительство обратило внимание на ИИ и понимает жесткие угрозы национальной безопасности. Но это регулирование путем указов. Что решит конкретный человек в администрации Трампа, то и станет политикой регулирования. Гораздо лучше было бы иметь прозрачное регулирование, основанное на верховенстве закона.
Джошуа Такер (Joshua A. Tucker) — американский политолог, профессор, преподает на кафедре политики факультета русских и славянских исследований в Нью-Йоркском университете. Возглавляет Центр им. Джордана по перспективным исследованиям России. Один из основателей и руководителей Центра социальных медиа, искусственного интеллекта и политики. Его ранние исследования касались массового политического поведения в посткоммунистических странах. В последние годы сосредоточился на пересечении цифровой информационной среды, социальных сетей и политики.
* Евгения Альбац в РФ объявлена «иностранным агентом».
** Meta признана в РФ «экстремистской организацией».
Фото: jordanrussiacenter.org